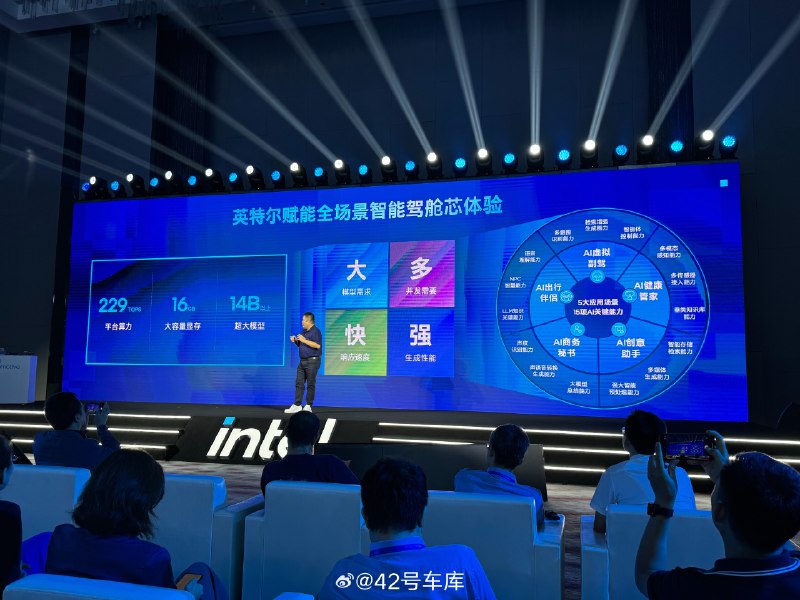
- 229 TOPS 算力
- 16GB GDDR6 显存
- 可以在本地运行 14B 以上的模型,可以同时运行 4-5 个 2B 的模型。
- token 时延 0.058 秒,吞吐量美妙 88 个 token,大概 150 字。
#42how##英特尔#
via 42号车库的微博
#42how##英特尔#
via 42号车库的微博
本页同步自 Tesla Share · @Tesla_share 的公开消息,保留频道正文和提供的参考来源。媒体报道、引用与频道整理请结合原始来源阅读;网站归档可能落后于频道编辑,最新版本请核对 Telegram 原文 ↗。
Tesla Share 是独立中文资讯频道,与 Tesla, Inc. 无隶属关系。了解来源与整理方式 →